Open LLM Notes · 课程首页
开源大模型底层原理
这不是又一份转载的科普。课程的三条底线:
一手数据
所有模型参数、架构配置均来自官方仓库、config.json 或技术报告原文,关键数字经脚本读取验证,不填没有出处的数。
结构级可视化
核心概念配自制动画——画的是网络结构与计算图(权重矩阵、数据流动、mask 方向),不是概念示意图。
从零实现 + 自验证
每课配动手脚本:从零写出关键部件,再与官方参照实现对拍,脚本自己判卷。
课程目录
第 0001 课 · 开源 LLM 解剖图:DeepSeek · GLM · Kimi
一张地图看懂三大旗舰的组成与差异:参数命名规则、MoE 稀疏激活、注意力机制对照表,以及如何亲手验证官网宣传的数字。读完能看懂任何开源模型的 config.json。
第 0002 课 · Tokenizer 与 BPE
文本如何变成 token 序列、词表从哪来、为什么"strawberry 数 r"会数错。配可交互的 BPE 训练模拟器与 GLM 真实词表实验脚本。
第 0003 课 · Attention:从零手写
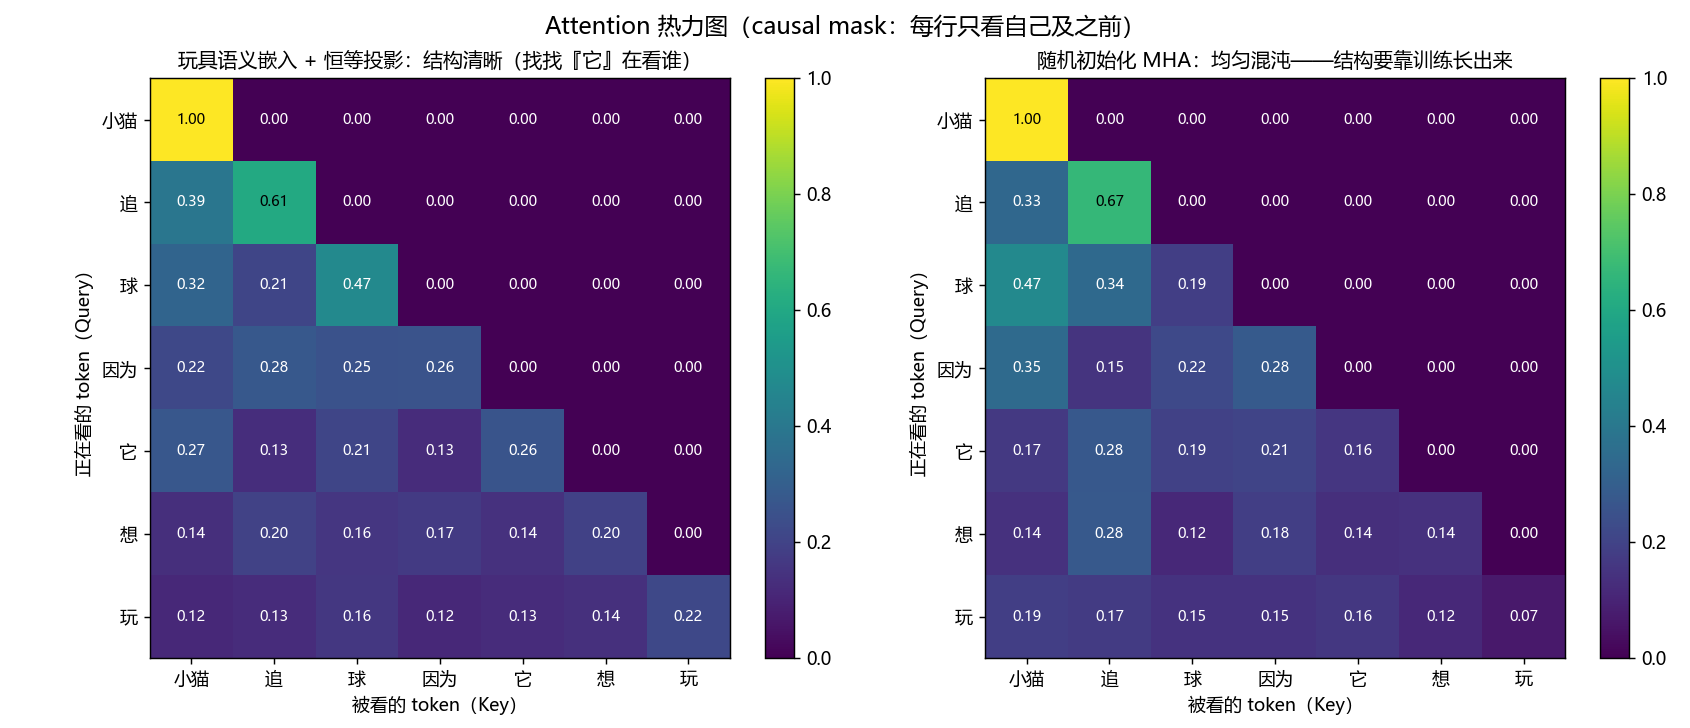
Q/K/V 投影、scaled dot-product、causal mask、多头注意力——配三个结构级动画面板(RNN 展开 / 全连接 / Attention 六幕计算图),以及与 PyTorch 官方实现对拍的自验证脚本和 attention 热力图。
第 0004 课 · RoPE:位置信息的打开方式
attention 天生"位置盲"(置换不变性)。RoPE 把位置变成旋转角度:绝对位置进、相对位置出;多频率时钟同时分辨远近;theta / partial_rotary_factor / rope_scaling 在三大模型 config 里的真实落点。配旋转动画面板与自验证脚本。
第 0005 课 · GQA 与 MLA:KV Cache 的压缩竞赛
逐 token 生成的显存账单(32K 对话 = 131 GB)引爆竞赛:GLM 的 GQA 用 12:1 分组共享换 12× 压缩,DeepSeek/Kimi 的 MLA 把 K/V 压进 512 维潜空间换 57×。三家 config 一手数字闭环第一课表格。配账单动画面板与双实现自验证脚本。
筹备中 · 第 0006 课:MoE——一支精英小队怎么干出万亿人次的活
参考资料
- 术语表 —— 全课程共用,随课更新
- FAQ · 第 1 课常见疑问
- 动手脚本 · attention_from_scratch.py(第 3 课,含运行判卷结果,附输出热力图)
- 动手脚本 · tokenizer_play.py(第 2 课,读取 GLM 真实词表)